Design Pattern kinh điển trong Linux Kernel (2/3): dữ liệu intrusive và concurrency
Phần 2 trong loạt 3 phần về design pattern của Linux kernel: cấu trúc dữ liệu intrusive và các kỹ thuật concurrency giúp fast path chạy nhanh.
Phần này tiếp nối phần 1 (OOP trong C, vòng đời và tài nguyên). Mục được đánh số theo bài gốc.
3. Cấu trúc dữ liệu intrusive
Trong kernel, node của list hay tree nằm bên trong object, chứ không phải object nằm trong node như std::list<T>. Nhờ vậy thêm phần tử không cần cấp phát thêm, xóa là O(1) khi đã có object, và một object có thể nằm trong nhiều list cùng lúc. Cơ chế phía sau chính là container_of ở mục 1.2.
3.1 list_head và iterator macro
struct list_head { struct list_head *next, *prev; };

struct mydev_req {
    u32              id;
    struct list_head node;      /* nằm trong pending list */
    struct list_head all;       /* đồng thời nằm trong list tổng */
};

static LIST_HEAD(pending);

list_add_tail(&req->node, &pending);

list_for_each_entry(req, &pending, node)
    pr_info("req %u\n", req->id);

/* Xóa trong lúc duyệt: phải dùng bản _safe */
list_for_each_entry_safe(req, tmp, &pending, node) {
    list_del(&req->node);
    kmem_cache_free(req_cache, req);
}
list_for_each_entry là một iterator viết bằng macro. Nó gọi container_of ở mỗi bước để trả về object, không phải node.
3.2 hlist, rbtree, xarray
hlist_headchỉ có một con trỏ, nhỏ bằng nửalist_head. Nó được dùng cho bucket của hash table, nơi có hàng nghìn head (xem<linux/hashtable.h>).rb_root** / **rb_root_cachedlà red-black tree intrusive. Bảncachedgiữ sẵn node trái nhất để lấy phần tử nhỏ nhất trong O(1), scheduler và hrtimer đều dùng.xarraythay cho radix tree, dùng cho ánh xạ index → pointer như page cache hay IDR.
Một điểm đặc trưng của rbtree: trong thời gian dài kernel không cung cấp hàm insert/search chung có callback so sánh. Người dùng tự viết vòng lặp duyệt rồi gọi rb_link_node() và rb_insert_color(), nhờ đó tối ưu được từng trường hợp và không tốn một lần gọi hàm gián tiếp mỗi bước so sánh. Từ 5.12 đã có rb_add() và rb_find(), nhưng chúng là hàm __always_inline, nên hàm so sánh vẫn được inline vào chỗ gọi. Đây là tinh thần "library, không phải framework" mà ta sẽ gặp lại ở mục 5.4.
Lỗi hay gặp
- Gọi
list_delbên tronglist_for_each_entry(bản không_safe). Saulist_del, con trỏnextbị gán giá trị poison (LIST_POISON1), nên vòng lặp crash ở bước kế tiếp. - Duyệt hoặc sửa list mà không giữ lock. Bản thân
list_headkhông tự đồng bộ: caller phải lock, hoặc dùng các biến thể_rcucho reader không lock. list_delmột node chưa từng được thêm vào list. HãyINIT_LIST_HEAD()mọi node và dùnglist_del_init()nếu có thể xóa hai lần.
4. Concurrency và hiệu năng
Ý tưởng chung của nhóm này là làm cho đường đọc phổ biến rẻ nhất có thể, kể cả khi điều đó khiến đường ghi đắt hơn. Với hệ thống realtime như gNodeB, đây cũng chính là cách thiết kế fast path.
4.1 RCU — Read-Copy-Update
Vấn đề. Dữ liệu được đọc hàng triệu lần mỗi giây nhưng hiếm khi đổi, ví dụ bảng routing hay config. Dùng rwlock thì reader vẫn phải ghi vào cache line của lock, gây bounce giữa các core.
Cách làm. Reader không lấy lock, không ghi gì vào bộ nhớ chung. Writer tạo bản copy, sửa bản copy, đổi con trỏ bằng một lệnh ghi atomic, rồi chờ một grace period (khi mọi reader cũ đã ra khỏi critical section) mới giải phóng bản cũ.
struct cfg { int mode; u32 rate; };
static struct cfg __rcu *cur_cfg;
static DEFINE_MUTEX(cfg_lock);          /* chỉ dành cho writer */

/* Reader: không lock, không chờ */
rcu_read_lock();
c = rcu_dereference(cur_cfg);
use(c->mode, c->rate);
rcu_read_unlock();

/* Writer: copy -> update -> publish -> chờ -> free */
new = kmalloc(sizeof(*new), GFP_KERNEL);
mutex_lock(&cfg_lock);
old = rcu_dereference_protected(cur_cfg, lockdep_is_held(&cfg_lock));
*new = *old;
new->rate = 2000;
rcu_assign_pointer(cur_cfg, new);
mutex_unlock(&cfg_lock);
synchronize_rcu();      /* hoặc kfree_rcu() để không phải chờ */
kfree(old);
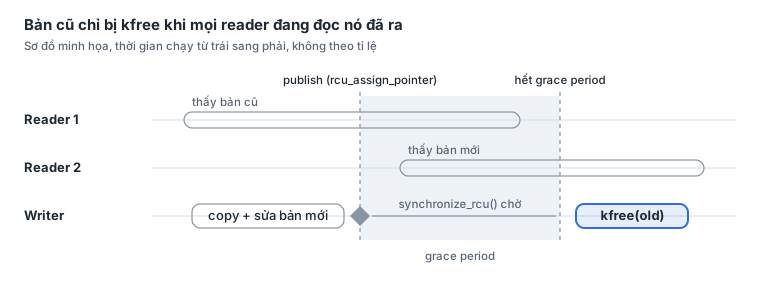
Hình 1. RCU · publish, grace period, kfree
Reader 1 vào trước publish nên vẫn thấy bản cũ; Reader 2 vào sau nên thấy bản mới. Writer chỉ giải phóng bản cũ sau khi Reader 1 đã ra khỏi critical section.
Cần nhớ.
- Không được sleep trong
rcu_read_lock(). Nếu bắt buộc phải sleep, dùng SRCU. - Không giữ con trỏ lấy từ
rcu_dereference()saurcu_read_unlock(). Muốn giữ lâu thì phải lấy refcount (mục 2.1, phần 1). - RCU chỉ bảo vệ reader với writer. Các writer với nhau vẫn cần lock riêng.
- Bản copy là bất biến sau khi publish. Sửa trực tiếp
c->rateở phía reader là sai pattern.
4.2 Per-CPU data
Vấn đề. Một counter thống kê bị mọi core cập nhật trên fast path, và atomic trên một cache line chung rất đắt.
Cách làm. Mỗi CPU một bản riêng, cộng dồn lại khi cần đọc. Đọc thì hiếm, ghi thì liên tục.
static DEFINE_PER_CPU(u64, rx_pkts);

this_cpu_inc(rx_pkts);                  /* fast path, không lock */

for_each_possible_cpu(cpu)              /* slow path */
    total += per_cpu(rx_pkts, cpu);
Pattern này giống hệt biến per-lcore và thống kê per-queue bên DPDK. Lưu ý trên kiến trúc 32-bit, đọc một u64 không atomic, nên networking dùng thêm u64_stats_sync.
4.3 Seqlock
Vấn đề. Dữ liệu nhỏ, đọc rất nhiều, writer không được phép bị reader làm nghẽn (điển hình là timekeeping).
Cách làm. Writer tăng một số thứ tự trước và sau khi ghi. Reader đọc không lock, nếu thấy số thứ tự đã đổi thì đọc lại.
/* Reader */
do {
    seq = read_seqbegin(&ts_lock);
    snapshot = shared_ts;
} while (read_seqretry(&ts_lock, seq));

/* Writer */
write_seqlock(&ts_lock);
shared_ts = new_ts;
write_sequnlock(&ts_lock);
Reader có thể đọc phải dữ liệu đang ghi dở, nên không được dereference con trỏ trong vòng đọc. Seqlock chỉ hợp với dữ liệu dạng giá trị.
4.4 Deferred work — top half / bottom half
Vấn đề. Interrupt handler phải xong thật nhanh, nhưng phần xử lý thực (copy dữ liệu, gọi stack, có khi cần sleep) thì lâu.
Cách làm. Hard IRQ chỉ ack phần cứng và hẹn việc. Phần còn lại chạy sau trong một trong các cơ chế dưới đây.
| Cơ chế | Context | Được sleep | Dùng khi |
|---|---|---|---|
| Hard IRQ handler | interrupt | Không | Ack phần cứng, đọc status, hẹn việc |
Threaded IRQ (request_threaded_irq) |
kernel thread | Có | Driver thông thường, nhất là hệ thống RT |
| Softirq | softirq | Không | Chỉ core kernel (NET_RX, timer, block) |
| NAPI poll | softirq | Không | Nhận gói tin trong network driver |
Tasklet / BH workqueue (WQ_BH) |
softirq | Không | Code cũ; tasklet đang được thay bằng BH workqueue từ 6.9 |
| Workqueue | kernel thread | Có | Việc dài, cần mutex, I2C/SPI, cấp phát GFP_KERNEL |
Với PREEMPT_RT (đã vào mainline từ 6.12), hầu hết IRQ handler bị ép chạy dạng thread. Viết driver theo kiểu threaded IRQ ngay từ đầu giúp hành vi giống nhau giữa kernel thường và kernel RT.
4.5 Static key — nhánh gần như miễn phí
Vấn đề. Một điều kiện hiếm khi bật (tracing, debug, feature flag) lại nằm trên đường nóng nhất. Ngay cả một lệnh load và branch cũng là quá nhiều.
Cách làm. Kernel biên dịch nhánh thành một lệnh NOP, khi bật key thì patch code lúc runtime thành lệnh JMP.
DEFINE_STATIC_KEY_FALSE(mydev_trace_on);

if (static_branch_unlikely(&mydev_trace_on))
    mydev_trace(pkt);            /* bình thường chỉ tốn một NOP */

static_branch_enable(&mydev_trace_on);   /* đắt: patch code, đồng bộ mọi CPU */
Tracepoint dùng chính cơ chế này, nên kernel có hàng nghìn tracepoint mà chi phí gần như bằng 0 khi tắt. Đổi trạng thái key rất đắt, nên chỉ dùng cho cờ ít khi thay đổi.
Phần trước: Phần 1 · Phần sau: Phần 3 · Mục lục cả loạt